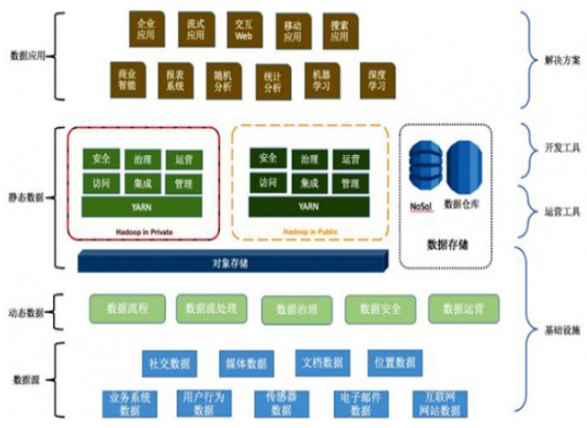
在《Hadoop數(shù)據(jù)分析》的第二章中,作者深入探討了作為大數(shù)據(jù)核心基礎(chǔ)設(shè)施的“大數(shù)據(jù)操作系統(tǒng)”概念,并著重分析了其數(shù)據(jù)處理和存儲支持服務(wù)。本章內(nèi)容揭示了Hadoop生態(tài)系統(tǒng)如何扮演類似傳統(tǒng)操作系統(tǒng)的角色,為上層應(yīng)用提供基礎(chǔ)資源管理和服務(wù)支撐,而數(shù)據(jù)處理與存儲正是其兩大基石。
一、 數(shù)據(jù)處理支持服務(wù):批處理與交互式查詢的引擎
數(shù)據(jù)處理是大數(shù)據(jù)價值實現(xiàn)的關(guān)鍵環(huán)節(jié)。Hadoop生態(tài)系統(tǒng)提供了多樣化的處理框架以滿足不同場景的需求:
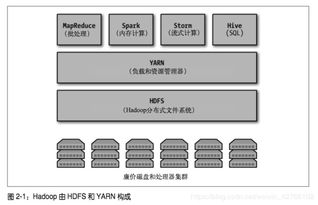
- 批處理引擎(MapReduce):作為Hadoop最初的編程模型,MapReduce通過“分而治之”的思想,將大規(guī)模數(shù)據(jù)集的處理任務(wù)分解為Map(映射)和Reduce(歸約)兩個階段。它擅長處理海量歷史數(shù)據(jù)的離線分析,其高容錯性和可擴(kuò)展性是其核心優(yōu)勢。其多階段磁盤I/O的特性也導(dǎo)致了較高的延遲。
- 交互式查詢引擎(Hive, Impala):為了滿足更快的即席查詢需求,以Hive(基于MapReduce或Tez/Spark)和Impala(MPP架構(gòu))為代表的SQL-on-Hadoop工具應(yīng)運而生。它們允許用戶使用熟悉的SQL語言對存儲在HDFS或HBase中的數(shù)據(jù)進(jìn)行查詢和分析,極大地降低了大數(shù)據(jù)分析的技術(shù)門檻,提高了開發(fā)效率。
- 流處理引擎(Spark Streaming, Flink, Storm):對于需要實時或近實時處理無界數(shù)據(jù)流的場景(如日志監(jiān)控、實時推薦),Spark的微批處理、Flink的純流處理以及Storm等框架提供了強(qiáng)大的支持,實現(xiàn)了從“存儲后分析”到“運動中分析”的范式轉(zhuǎn)變。
二、 存儲支持服務(wù):分層化與多元化的數(shù)據(jù)湖倉
可靠、可擴(kuò)展且經(jīng)濟(jì)的存儲是數(shù)據(jù)處理的前提。Hadoop的存儲體系已從單一的HDFS演變?yōu)橐粋€層次分明、功能互補(bǔ)的生態(tài)系統(tǒng):
- 分布式文件系統(tǒng)(HDFS):作為基石,HDFS以“一次寫入、多次讀取”的模式,將超大文件分塊存儲在廉價的商用服務(wù)器集群上,提供了極高的吞吐量和容錯能力。它是原始數(shù)據(jù)、清洗后數(shù)據(jù)以及需要批量處理數(shù)據(jù)的主要歸宿。
- NoSQL數(shù)據(jù)庫(HBase):建立在HDFS之上的HBase是一個分布式、列式存儲的NoSQL數(shù)據(jù)庫。它支持海量數(shù)據(jù)的隨機(jī)、實時讀寫訪問,非常適合作為需要低延遲查詢的在線應(yīng)用(如用戶畫像查詢、消息歷史記錄)的存儲后端,彌補(bǔ)了HDFS在隨機(jī)訪問能力上的不足。
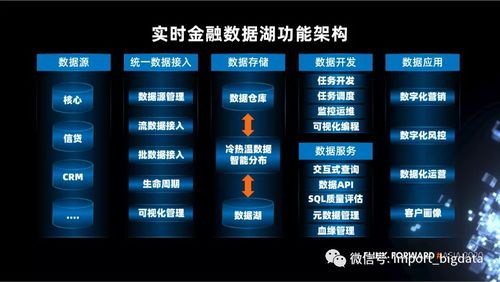
- 數(shù)據(jù)倉庫與數(shù)據(jù)湖(Hive, Kudu):Hive的表結(jié)構(gòu)(Metadata)管理能力,使其在HDFS之上構(gòu)建了一個邏輯數(shù)據(jù)倉庫。而像Kudu這樣的存儲引擎,則試圖融合HDFS的吞吐量和HBase的隨機(jī)訪問性能,為需要同時支持快速分析查詢和實時更新的場景提供了新的選擇。
三、 協(xié)同工作與核心思想
數(shù)據(jù)處理與存儲服務(wù)并非孤立運行。一個典型的數(shù)據(jù)管道可能是:原始日志實時攝入Kafka,由Spark Streaming進(jìn)行初步處理和清洗后,將結(jié)果寫入HDFS作為長期歸檔,同時將聚合后的關(guān)鍵指標(biāo)寫入HBase供儀表盤實時展示;而周期性的深度分析任務(wù)則由Hive或Spark SQL在HDFS的數(shù)據(jù)上運行。
本章的核心思想在于闡明,一個成熟的大數(shù)據(jù)操作系統(tǒng)(以Hadoop生態(tài)為代表)通過提供多元化的處理范式和分層化的存儲方案,使企業(yè)能夠根據(jù)數(shù)據(jù)的特性(體量、速度、多樣性)和價值密度,靈活地選擇性價比最優(yōu)的技術(shù)組合,從而構(gòu)建起一個統(tǒng)一、彈性、高效的數(shù)據(jù)平臺。這為實現(xiàn)從數(shù)據(jù)到洞察、再到?jīng)Q策的完整價值鏈奠定了堅實的技術(shù)基礎(chǔ)。
思考與啟示:隨著云原生和存算分離架構(gòu)的興起,大數(shù)據(jù)操作系統(tǒng)的內(nèi)涵正在不斷擴(kuò)展。但無論如何演變,其對數(shù)據(jù)處理與存儲基礎(chǔ)服務(wù)的抽象、管理與優(yōu)化,始終是支撐一切上層智能應(yīng)用的根本。